



- Wat is technische SEO?
- Crawlen, renderen en indexeren uitgelegd
- Robots.txt begrijpen
- Noindex, nofollow en robots meta tags
- XML-sitemap maken en controleren
- Canonical tags en duplicate content
- Redirects, 404-fouten en statuscodes oplossen
- Website structuur en crawlbaarheid
- Core Web Vitals en pagespeed voor SEO
- Technische SEO voor afbeeldingen
- Mobielvriendelijkheid en responsive SEO
- JavaScript SEO
- Schema markup technisch implementeren
- Technische SEO-audit: problemen vinden en prioriteren
Crawlen, renderen en indexeren uitgelegd

- Geschreven door:
- Vito Havik
Een pagina online zetten is niet genoeg.
Google moet de pagina eerst kunnen vinden.
Daarna moet Google de pagina kunnen ophalen.
Vervolgens moet de pagina goed verwerkt worden.
Pas daarna kan de pagina in de index terechtkomen.
Dat proces klinkt technisch.
Maar het is de basis van technische SEO.
Want een pagina die niet goed gecrawld, gerenderd of geïndexeerd wordt, kan moeilijk SEO-resultaat opleveren.
Ook niet als de content sterk is.
Ook niet als de title tag goed staat.
Ook niet als je zoekwoorden netjes verwerkt zijn.
Technische SEO begint daarom met een simpele vraag:
kan Google deze pagina goed verwerken?
Om dat te begrijpen, moet je drie begrippen kennen:
crawlen, renderen en indexeren.
🧭 Waarom crawlen, renderen en indexeren belangrijk zijn
Technische SEO draait voor een groot deel om toegankelijkheid.
Niet alleen voor gebruikers.
Maar ook voor zoekmachines.
Een zoekmachine moet een pagina kunnen ontdekken, openen, begrijpen en opslaan voordat die pagina zichtbaar kan worden in de zoekresultaten.
Dat gebeurt niet automatisch omdat een pagina live staat.
Een pagina kan online zijn, maar toch lastig vindbaar zijn voor Google.
Bijvoorbeeld omdat:
- er geen interne links naartoe staan
- de pagina wordt geblokkeerd in robots.txt
- de pagina een noindex-tag heeft
- de server fouten geeft
- belangrijke content pas via JavaScript verschijnt
- de canonical naar een andere URL wijst
- de pagina te veel lijkt op een andere pagina
- Google de pagina wel kent, maar niet waardevol genoeg vindt om te indexeren
Daarom is dit onderwerp zo belangrijk.
Crawlen, renderen en indexeren vormen de technische route die een pagina moet afleggen voordat hij kan ranken.
Zie het als een controle bij de ingang.
Eerst moet Google binnen kunnen komen.
Daarna moet Google zien wat er op de pagina staat.
Daarna beslist Google of de pagina wordt opgenomen in de index.
Als ergens in dat proces iets misgaat, kan de pagina blijven hangen.
Niet omdat het onderwerp slecht is.
Maar omdat de technische verwerking niet goed loopt.
🤖 Wat crawlen betekent
Crawlen betekent dat een zoekmachine een URL bezoekt en de inhoud ophaalt.
Google gebruikt daarvoor Googlebot.
Googlebot ontdekt URL’s op verschillende manieren.
Bijvoorbeeld via:
- interne links
- externe links
- XML-sitemaps
- eerder bekende URL’s
- redirects
- pagina’s die opnieuw gecontroleerd worden
Crawlen is dus het ophalen van een pagina.
Maar dat betekent nog niet dat de pagina ook geïndexeerd wordt.
Dat is een belangrijk verschil.
Een pagina kan wel gecrawld zijn, maar alsnog niet in de index komen. Bijvoorbeeld omdat er een noindex-tag op staat, omdat Google een andere URL als betere versie ziet of omdat de pagina te weinig unieke waarde heeft.
Crawlen is dus stap één.
Niet het eindpunt.
🕸️ Hoe Googlebot URL’s ontdekt
Googlebot ontdekt nieuwe pagina’s vooral via links.
Als pagina A naar pagina B linkt, kan Google die link volgen en pagina B ontdekken. Daarom zijn interne links zo belangrijk voor technische SEO.
Ze laten zien welke pagina’s bestaan.
Hoe pagina’s met elkaar verbonden zijn.
En welke pagina’s een duidelijke plek hebben binnen je website.
Een pagina zonder interne links hangt sneller los.
Zo’n pagina noemen we vaak een orphan page.
Google kan zo’n URL soms alsnog vinden via een XML-sitemap of externe link, maar zonder interne links krijgt de pagina minder context. De pagina bestaat dan wel, maar binnen je eigen website wijst er niets naartoe.
Vergelijk het met een product in een winkel.
Ligt het product netjes in het schap, dan vinden klanten het makkelijk. Staat het ergens achterin een afgesloten opslagruimte, dan bestaat het nog steeds.
Maar niemand loopt er vanzelf naartoe.
Zo werkt het ook met pagina’s.
Als een belangrijke pagina niet intern bereikbaar is, maak je het zoekmachines onnodig moeilijk om die pagina te ontdekken, te begrijpen en op waarde te schatten.
🚪 Crawlen betekent niet automatisch toegang
Googlebot kan een URL alleen crawlen als hij toegang krijgt.
Soms wordt crawling bewust of onbewust geblokkeerd.
Bijvoorbeeld via robots.txt.
Robots.txt kan zoekmachines vertellen welke delen van een site ze wel of niet mogen crawlen. Dat kan nuttig zijn, maar het wordt vaak verkeerd begrepen.
Robots.txt is vooral een manier om crawling te sturen.
Niet om een pagina betrouwbaar uit de index te houden.
Als je niet wilt dat een pagina in Google verschijnt, gebruik je meestal noindex of scherm je de pagina af.
Dat verschil komt later in de module uitgebreider terug.
Voor nu is vooral belangrijk:
crawlen betekent dat Google de URL mag en kan ophalen.
Zonder crawling kan Google de pagina niet goed verwerken.
🧱 Wat renderen betekent
Renderen betekent dat Google een pagina verwerkt zoals een browser dat doet.
Of simpeler gezegd:
Google probeert te zien wat er na het laden van de pagina daadwerkelijk op de pagina staat.
Bij eenvoudige HTML-pagina’s is dat vaak vrij direct. De belangrijkste tekst, links en content staan meteen in de HTML, waardoor Google veel informatie direct kan verwerken.
Maar bij moderne websites is dat niet altijd zo.
Sommige pagina’s bouwen belangrijke onderdelen pas op nadat JavaScript is geladen.
Denk aan:
- productinformatie
- reviews
- interne links
- filters
- tabbladen
- tekstblokken
- afbeeldingen
- navigatie-elementen
Voor een gebruiker kan dat prima werken.
Die opent de pagina in een browser en ziet alles verschijnen.
Maar voor SEO moet je ook controleren of Google die inhoud goed kan verwerken.
Daar komt renderen om de hoek kijken.
⚙️ Waarom JavaScript renderen belangrijk maakt
JavaScript is niet slecht voor SEO.
Maar het maakt technische SEO wel gevoeliger.
Als belangrijke content pas na JavaScript verschijnt, moet Google die pagina goed kunnen renderen om de inhoud te zien.
Gaat dat mis, dan kan Google belangrijke onderdelen missen.
Een webshopcategorie kan bijvoorbeeld producten tonen die pas na JavaScript worden geladen. Voor de gebruiker werkt alles prima, maar als Google de producten niet goed ziet, lijkt de categoriepagina veel leger dan hij is.
Of denk aan interne links naar vervolgartikelen.
Als die links pas via een script worden toegevoegd en niet goed crawlbaar zijn, mist Google mogelijk belangrijke routes door de site.
Daarom is renderen vooral belangrijk bij websites die zwaar leunen op JavaScript.
Niet elk renderprobleem is direct rampzalig.
Maar als belangrijke content, links of signalen pas na rendering beschikbaar zijn, moet je extra goed testen.
👀 Renderen gaat over wat Google echt ziet
Het verschil tussen wat jij ziet en wat Google ziet, kan groter zijn dan je denkt.
Jij ziet een volledige pagina.
Met tekst.
Knoppen.
Afbeeldingen.
Navigatie.
Producten.
Reviews.
Interne links.
Maar Google moet die onderdelen technisch kunnen ophalen en verwerken.
Daarom is het niet genoeg om alleen de zichtbare pagina in je browser te bekijken.
Bij technische SEO wil je ook weten:
- staat belangrijke content in de HTML?
- kan Google JavaScript goed verwerken?
- zijn links echte crawlbare links?
- worden scripts of bestanden niet geblokkeerd?
- is de mobiele versie volledig?
- verschijnt content niet pas te laat of op een onbetrouwbare manier?
Renderen is dus de brug tussen ophalen en begrijpen.
Google crawlt de URL.
Daarna moet Google de pagina kunnen verwerken zoals die bedoeld is.
📚 Wat indexeren betekent
Indexeren betekent dat Google informatie van een pagina verwerkt en kan opnemen in de index.
De index kun je zien als de database waaruit Google zoekresultaten kan tonen.
Als een pagina niet geïndexeerd is, kan hij normaal gesproken niet ranken in Google.
Maar ook hier zit nuance.
Een pagina die gecrawld is, wordt niet automatisch geïndexeerd. Google kan een pagina ophalen en daarna besluiten om hem niet op te nemen.
Dat kan verschillende redenen hebben.
Bijvoorbeeld:
- de pagina heeft een noindex-tag
- de canonical wijst naar een andere URL
- de content lijkt te veel op een andere pagina
- de pagina heeft weinig unieke waarde
- de pagina geeft een foutstatus
- de pagina lijkt een soft 404
- de inhoud is niet goed zichtbaar na renderen
Indexeren is dus niet alleen een technische stap.
Het is ook een kwaliteits- en selectiestap.
Google hoeft niet elke bekende URL op te nemen in de index.
🛑 Noindex blokkeert indexatie
Noindex is een instructie waarmee je aangeeft dat een pagina niet in de index moet komen.
Dat is iets anders dan robots.txt.
Robots.txt gaat over crawling.
Noindex gaat over indexatie.
Dit verschil is belangrijk.
Als je een pagina via robots.txt blokkeert, kan Google de pagina niet goed crawlen. Daardoor kan Google een noindex-tag op die pagina ook niet altijd zien.
Wil je een pagina uit de index houden, dan moet Google de pagina kunnen crawlen om de noindex-instructie te lezen.
Daarom gaat het in technische SEO vaak mis wanneer robots.txt en noindex door elkaar worden gebruikt.
Robots.txt zegt:
kom hier niet crawlen.
Noindex zegt:
neem deze pagina niet op in de index.
Dat zijn twee verschillende dingen.
📌 Geïndexeerd betekent niet automatisch hoog ranken
Ook dit is belangrijk.
Een pagina kan geïndexeerd zijn, maar nauwelijks verkeer krijgen.
Indexatie betekent alleen dat de pagina in aanmerking kan komen om getoond te worden. Daarna spelen andere factoren een rol.
Zoals:
- relevantie
- zoekintentie
- contentkwaliteit
- autoriteit
- interne links
- technische kwaliteit
- concurrentie
- gebruikerservaring
Indexatie is dus nodig.
Maar niet genoeg.
Eerst moet een pagina in de index kunnen komen.
Daarna moet de pagina goed genoeg zijn om te ranken.
🔁 Hoe crawlen, renderen en indexeren samen werken
Crawlen, renderen en indexeren zijn losse begrippen.
Maar in de praktijk hangen ze sterk samen.
Het proces ziet er versimpeld zo uit:
- Google ontdekt een URL
- Googlebot probeert de URL te crawlen
- Google haalt de HTML op
- Google verwerkt de pagina
- Google rendert de pagina wanneer dat nodig is
- Google beoordeelt de content en signalen
- Google beslist of en hoe de pagina in de index komt
Dat klinkt lineair.
Maar in werkelijkheid loopt het niet altijd zo netjes.
Google kan een pagina opnieuw crawlen.
Renderen kan later plaatsvinden.
Indexatie kan uitblijven.
En wijzigingen worden niet altijd direct verwerkt.
Als je vandaag een pagina aanpast, betekent dat niet dat Google die wijziging morgen al volledig heeft meegenomen.
Soms gaat het snel.
Soms duurt het langer.
Vooral bij grotere websites, nieuwe pagina’s of minder belangrijke URL’s kan verwerking tijd kosten.
🔄 Google komt terug
Crawlen is geen eenmalige actie.
Googlebot komt terug om pagina’s opnieuw te bekijken.
Hoe vaak dat gebeurt, hangt onder andere af van de website, de pagina, de interne links, de populariteit en hoe vaak content verandert.
Een nieuwsartikel kan vaker opnieuw gecontroleerd worden dan een oude pagina die nauwelijks verandert.
Een belangrijke categoriepagina kan vaker gecrawld worden dan een diepe filter-URL zonder waarde.
Daarom wil je belangrijke pagina’s technisch goed bereikbaar maken.
Niet ergens diep verstoppen.
Niet zonder interne links.
Niet met onnodige redirects.
Niet met verwarrende canonicals.
Hoe duidelijker de technische signalen, hoe makkelijker Google de juiste pagina’s kan verwerken.
🚧 Wat er mis kan gaan tijdens crawlen
Veel technische SEO-problemen beginnen al bij crawlen.
Google kan een pagina niet goed verwerken als de URL niet bereikbaar, vindbaar of toegestaan is.
🔗 De pagina is niet intern gelinkt
Een belangrijke pagina zonder interne links is lastig te ontdekken.
Hij staat misschien wel in je CMS, maar binnen de website heeft hij geen duidelijke plek.
Dat maakt de pagina zwakker.
Voor gebruikers én zoekmachines.
Een sitemap kan helpen.
Maar interne links blijven belangrijk.
Ze geven context en route.
📄 De URL staat niet in de sitemap
Een XML-sitemap is geen garantie dat Google een pagina crawlt of indexeert.
Maar hij helpt wel om belangrijke URL’s door te geven.
Vooral bij grote websites, nieuwe pagina’s of pagina’s die niet makkelijk via links worden ontdekt.
Als belangrijke pagina’s ontbreken in de sitemap, mis je een extra ontdekkingssignaal.
🚫 Robots.txt blokkeert de URL
Soms wordt een belangrijke map per ongeluk geblokkeerd.
Bijvoorbeeld:
/blog/
/producten/
/categorie/
Dan kan Google die URL’s niet goed crawlen.
Dat kan grote gevolgen hebben.
Zeker wanneer de blokkade op een belangrijk deel van de website staat.
🧯 De server geeft fouten
Als een pagina regelmatig serverfouten geeft, kan Google hem niet betrouwbaar ophalen.
Denk aan 5xx-fouten.
Bijvoorbeeld wanneer de server overbelast is.
Of wanneer er technische problemen zijn na een update.
Een pagina moet stabiel bereikbaar zijn.
Anders wordt crawlen lastiger.
🕳️ Belangrijke pagina’s zitten te diep
Als een belangrijke pagina pas na veel klikken bereikbaar is, krijgt hij minder sterke interne signalen.
Diepe pagina’s zijn niet altijd slecht.
Maar belangrijke pagina’s moeten niet onnodig diep verstopt zitten.
Vooral niet als ze moeten ranken.
🧭 Links zijn niet goed crawlbaar
Niet elke klikbare knop is automatisch een goede crawlbare link.
Voor SEO zijn gewone HTML-links belangrijk.
Als belangrijke routes alleen via scripts, knoppen of complexe interacties werken, kan Google ze minder goed volgen.
Daarom controleer je bij technische SEO niet alleen of gebruikers kunnen klikken.
Je controleert ook of zoekmachines de links goed kunnen ontdekken.
⚠️ Wat er mis kan gaan tijdens renderen
Renderproblemen ontstaan vooral wanneer de pagina anders werkt voor Google dan voor gebruikers.
Dat gebeurt vaak bij JavaScript, lazy loading of mobiele verschillen.
🧩 Belangrijke content verschijnt pas laat
Soms wordt content pas geladen na een interactie.
Bijvoorbeeld na klikken, scrollen of filteren.
Voor gebruikers kan dat handig zijn, maar voor Google kan het betekenen dat belangrijke inhoud minder goed zichtbaar is.
Zeker als die content nodig is om de pagina te begrijpen.
🔗 Interne links worden via scripts toegevoegd
Interne links zijn belangrijk voor crawlbaarheid.
Als die links pas via JavaScript worden opgebouwd, moet je controleren of Google ze goed kan zien en volgen.
Anders kunnen belangrijke pagina’s minder goed ontdekt worden.
🖼️ Lazy loading werkt verkeerd
Lazy loading kan goed zijn voor snelheid.
Maar het moet correct worden ingericht.
Als afbeeldingen of content pas laden wanneer een gebruiker scrolt, moet je controleren of belangrijke onderdelen alsnog goed beschikbaar zijn.
Vooral wanneer lazy loading niet alleen afbeeldingen raakt, maar ook tekst of links.
📱 Mobiele versie mist content
Google gebruikt de mobiele versie als uitgangspunt voor indexering en ranking.
Daarom moet belangrijke content ook op mobiel beschikbaar zijn.
Niet alleen op desktop.
Als desktop veel inhoud toont en mobiel een uitgeklede versie is, kan dat problemen geven. Vooral wanneer belangrijke tekst, links, structured data of afbeeldingen ontbreken op mobiel.
🚧 Scripts of bestanden worden geblokkeerd
Soms zijn CSS- of JavaScript-bestanden geblokkeerd.
Dan kan Google de pagina minder goed renderen.
Voor de gebruiker lijkt de pagina misschien normaal.
Maar voor Google ontbreekt een deel van wat nodig is om de pagina goed te verwerken.
Daarom moet je bij renderproblemen niet alleen naar de pagina kijken.
Maar ook naar de bestanden die nodig zijn om die pagina op te bouwen.
📉 Wat er mis kan gaan tijdens indexeren
Ook als crawlen en renderen goed gaan, kan indexatie uitblijven.
Dat voelt soms frustrerend.
Maar het is niet altijd een fout.
Google beslist zelf of een pagina wordt opgenomen in de index.
🛑 De pagina heeft noindex
Dit is de meest directe oorzaak.
Als een pagina noindex heeft, geef je aan dat hij niet in de index moet komen.
Dat kan bewust zijn.
Bijvoorbeeld bij bedankpagina’s, interne zoekresultaten of tijdelijke pagina’s.
Maar het kan ook per ongeluk gebeuren.
Bijvoorbeeld na een stagingomgeving, plugin-instelling of templatewijziging.
🔁 De canonical wijst naar een andere URL
Een canonical tag geeft aan welke URL de voorkeursversie is.
Als de canonical van pagina A naar pagina B wijst, geef je een signaal dat B de belangrijkste versie is.
Dat kan goed zijn bij duplicate content.
Maar als een canonical verkeerd staat, kan Google de verkeerde pagina kiezen. Of pagina A niet indexeren omdat een andere URL als hoofdversie wordt gezien.
🪞 De pagina lijkt te veel op een andere pagina
Niet elke pagina met vergelijkbare content hoeft apart geïndexeerd te worden.
Als meerdere pagina’s bijna hetzelfde zeggen, kan Google ervoor kiezen één versie belangrijker te maken.
Dat zie je vaak bij:
- filterpagina’s
- locatiepagina’s met weinig unieke inhoud
- productvarianten
- tagpagina’s
- vergelijkbare blogartikelen
- gekopieerde teksten
Duplicate content is niet altijd een straf.
Maar het kan wel zorgen voor onduidelijkheid.
Welke pagina moet Google tonen?
🧻 De pagina heeft te weinig unieke waarde
Soms is een pagina technisch prima bereikbaar.
Maar inhoudelijk te dun.
De pagina zegt weinig nieuws.
Beantwoordt geen duidelijke vraag.
Of verschilt nauwelijks van andere pagina’s.
Dan kan Google besluiten om hem niet te indexeren.
Niet-indexatie is dus niet altijd puur technisch.
Soms is het een inhoudelijk signaal.
🧯 De pagina geeft de verkeerde statuscode
Een pagina die een foutstatus geeft, kan niet normaal geïndexeerd worden.
Denk aan 404 of 500.
Maar ook soft 404’s kunnen problemen geven.
Dat zijn pagina’s die technisch een 200-status geven, maar inhoudelijk lijken op een foutpagina.
Bijvoorbeeld:
“Deze pagina bestaat niet meer”
Maar dan met statuscode 200.
Dat is verwarrend.
Voor gebruikers.
En voor zoekmachines.
🧪 Hoe controleer je crawlen, renderen en indexeren?
Je hoeft niet te gokken of Google een pagina goed verwerkt.
Je kunt veel controleren.
Vooral met Google Search Console.
En met een crawltool wanneer je technische patronen op grotere schaal wilt vinden.
🔎 Gebruik URL-inspectie
Met URL-inspectie kun je een specifieke URL controleren.
Je ziet onder andere:
- of Google de URL kent
- of de URL geïndexeerd is
- wanneer de URL voor het laatst is gecrawld
- welke canonical Google heeft gekozen
- of er indexeringsproblemen zijn
- of de pagina mobiel bruikbaar lijkt
- of Google de live URL kan ophalen
Dit is vaak de eerste plek waar je kijkt bij indexatievragen.
Niet omdat Search Console alles perfect verklaart.
Maar omdat je snel ziet waar het probleem ongeveer zit.
🧪 Test de live URL
Een live test laat zien of Google de huidige versie van de pagina kan ophalen.
Dat is handig wanneer je net iets hebt aangepast.
Bijvoorbeeld:
- noindex verwijderd
- robots.txt aangepast
- canonical aangepast
- serverfout opgelost
- content toegevoegd
- JavaScriptprobleem opgelost
Let wel op:
een live test betekent niet dat Google de pagina meteen opnieuw indexeert.
Het laat vooral zien of de huidige pagina technisch opgehaald kan worden.
📄 Controleer het indexeringsrapport
Het indexeringsrapport in Search Console geeft inzicht in groepen URL’s.
Daar zie je bijvoorbeeld pagina’s die:
- geïndexeerd zijn
- uitgesloten zijn door noindex
- niet gevonden zijn
- redirects zijn
- gecrawld maar niet geïndexeerd zijn
- ontdekt maar niet geïndexeerd zijn
- een foutstatus geven
Dat helpt om patronen te herkennen.
Eén losse URL kan toeval zijn.
Maar honderd URL’s met hetzelfde probleem wijzen vaak op een template-, sitemap- of technische instelling.
🕷️ Gebruik een crawltool
Een crawltool zoals Screaming Frog helpt je om je website technisch door te lopen.
Niet pagina voor pagina met de hand.
Maar op schaal.
Zo zie je sneller hoe je website technisch in elkaar zit. Welke URL’s bereikbaar zijn, welke statuscodes ze geven, welke pagina’s interne links krijgen en waar technische signalen elkaar mogelijk tegenspreken.
Een crawltool kan bijvoorbeeld helpen bij het vinden van:
- interne links naar 404-pagina’s
- interne links naar redirects
- pagina’s met noindex
- pagina’s met verkeerde of ontbrekende canonicals
- belangrijke pagina’s die te diep in de site zitten
- pagina’s zonder interne links
- sitemap-URL’s die niet goed intern bereikbaar zijn
- dubbele title tags of meta descriptions
- verschillen tussen een normale HTML-crawl en JavaScript-rendering
Gebruik een crawltool wel naast Google Search Console.
Search Console laat zien wat Google rapporteert over je site.
Een crawltool laat zien hoe je website technisch is opgebouwd.
Samen geven ze een veel beter beeld dan één van de twee alleen.
🗺️ Controleer je sitemap
Bekijk of belangrijke URL’s in je XML-sitemap staan.
En of de sitemap alleen URL’s bevat die je echt geïndexeerd wilt hebben.
Een goede sitemap bevat geen rommel.
Dus liever geen:
- redirects
- 404’s
- noindex-pagina’s
- canonicalized URL’s
- tijdelijke URL’s
- filterpagina’s zonder waarde
De sitemap moet zoekmachines helpen.
Niet verwarren.
🧱 Bekijk de gerenderde pagina
Bij renderproblemen wil je weten wat Google of een tool na rendering ziet.
Controleer daarom:
- is de hoofdcontent zichtbaar?
- zijn interne links zichtbaar?
- worden afbeeldingen goed geladen?
- ontbreekt er content die gebruikers wel zien?
- werkt de mobiele versie volledig?
- worden scripts niet geblokkeerd?
Dit is vooral belangrijk bij JavaScript-websites.
En bij pagina’s waar content dynamisch wordt geladen.
🔗 Controleer interne links en statuscodes
Technische SEO stopt niet bij de pagina zelf.
Controleer ook hoe de pagina verbonden is.
Kijk naar:
- interne links naar de pagina
- interne links vanaf de pagina
- redirects
- 404’s
- statuscodes
- canonical tags
- robots-instellingen
Een pagina kan inhoudelijk goed zijn.
Maar technisch alsnog zwak verbonden.
Dan wordt het lastiger om de pagina goed te verwerken en op waarde te schatten.
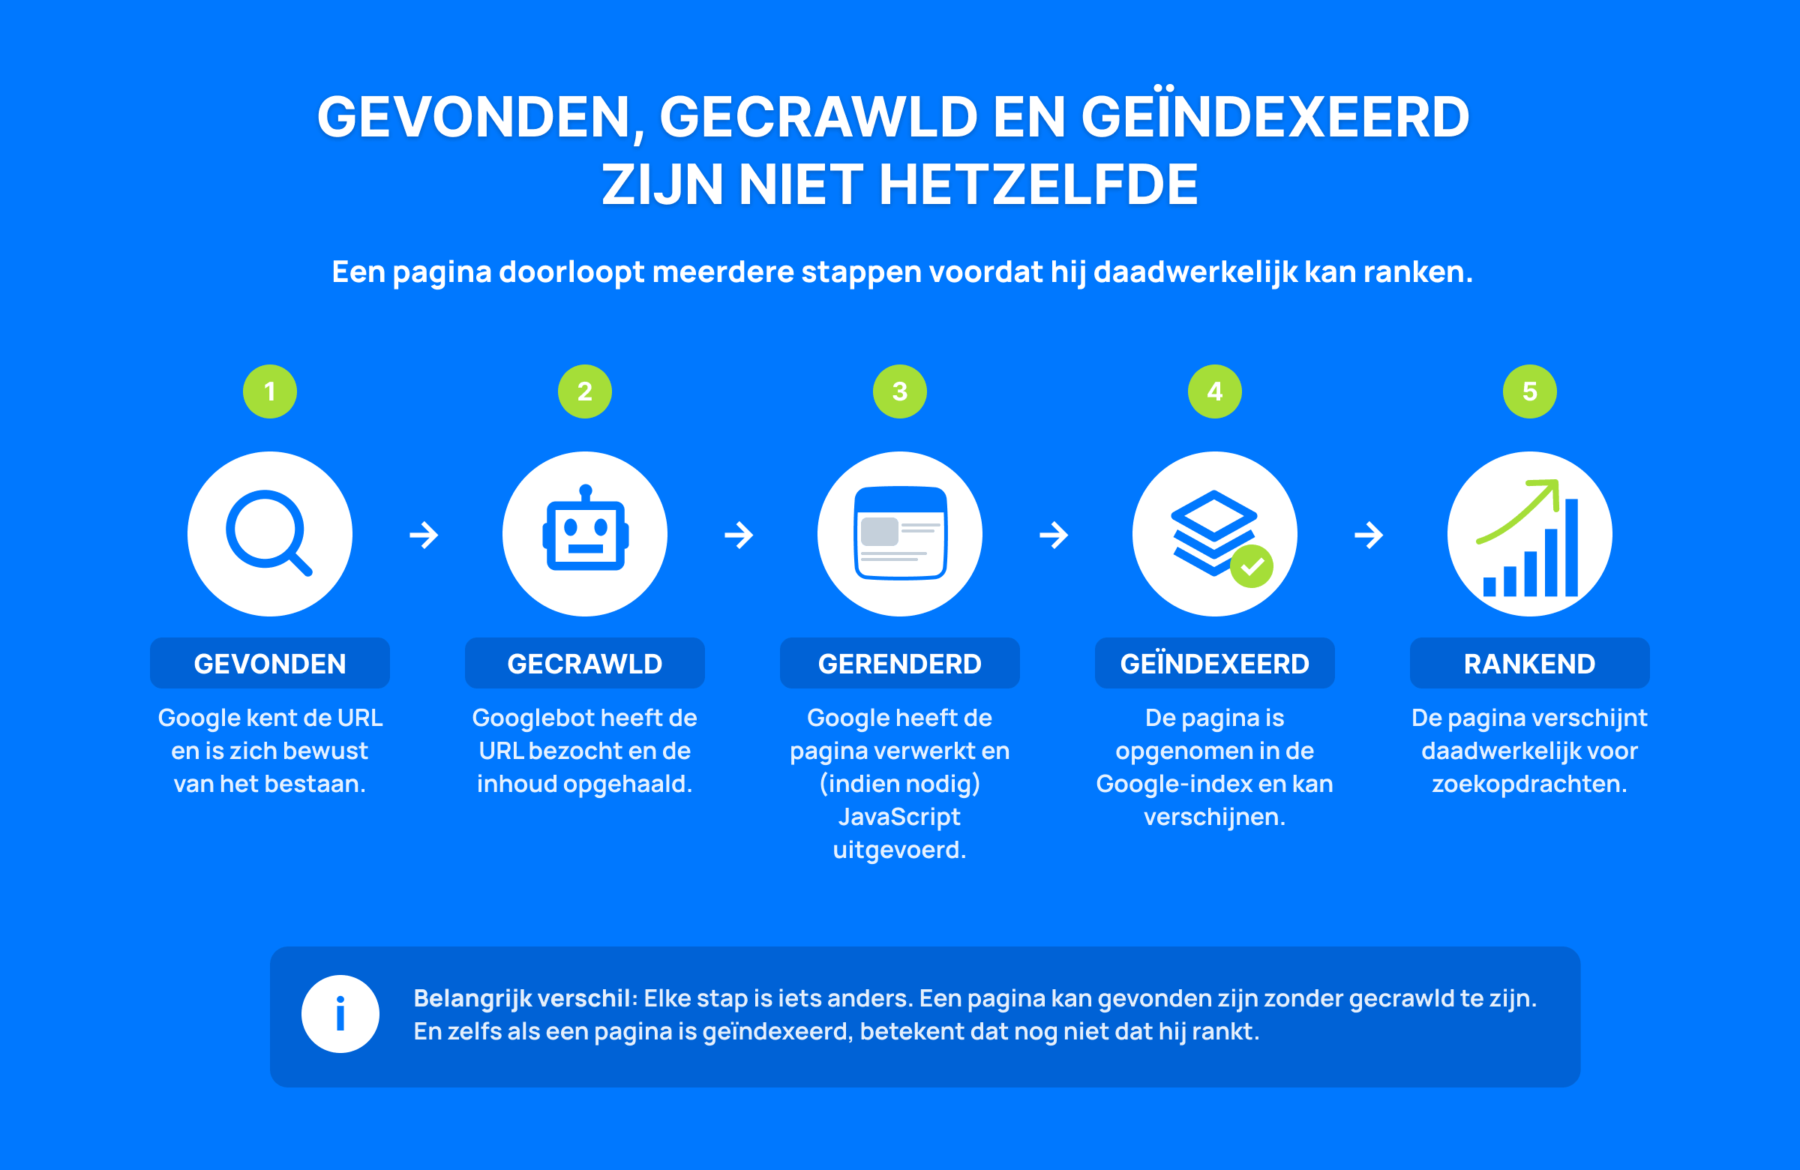
🧠 Gevonden, gecrawld en geïndexeerd zijn niet hetzelfde
Veel SEO-verwarring ontstaat doordat begrippen door elkaar lopen.
Iemand zegt:
“Google heeft de pagina toch gevonden?”
Maar gevonden is niet hetzelfde als geïndexeerd.
En geïndexeerd is niet hetzelfde als ranken.
Daarom is dit onderscheid belangrijk.
📍 Gevonden
Gevonden betekent dat Google de URL kent.
Bijvoorbeeld via een sitemap, link of eerder bezoek.
Maar Google hoeft de pagina nog niet volledig te hebben gecrawld.
Laat staan geïndexeerd.
🤖 Gecrawld
Gecrawld betekent dat Googlebot de URL heeft opgehaald.
De pagina is bezocht.
Maar dat betekent nog niet dat hij in de index staat.
Google kan na het crawlen alsnog besluiten om de pagina niet te indexeren.
🧱 Gerenderd
Gerenderd betekent dat Google de pagina heeft verwerkt zoals die geladen wordt.
Dat is vooral belangrijk wanneer JavaScript nodig is om content zichtbaar te maken.
Als renderen niet goed gaat, kan Google een onvolledig beeld krijgen.
📚 Geïndexeerd
Geïndexeerd betekent dat de pagina kan worden opgenomen in Google’s index.
Vanaf dat moment kan de pagina in aanmerking komen om getoond te worden bij zoekopdrachten.
Maar ook dan ben je er nog niet.
📈 Rankend
Rankend betekent dat de pagina daadwerkelijk zichtbaar is voor zoekopdrachten.
Een pagina kan geïndexeerd zijn, maar nergens goed ranken.
Bijvoorbeeld omdat de content niet sterk genoeg is.
Of omdat de zoekintentie niet goed wordt bediend.
Of omdat concurrerende pagina’s beter zijn.
De route is dus:
gevonden → gecrawld → gerenderd → geïndexeerd → rankend
Elke stap heeft zijn eigen problemen.
En elke stap vraagt om een andere oplossing.
🚀 Waarom dit de basis is voor technische SEO
Crawlen, renderen en indexeren zijn de basis van technische SEO.
Want bijna elk technisch SEO-onderwerp raakt één van deze drie stappen.
Robots.txt beïnvloedt crawling.
Noindex beïnvloedt indexatie.
Sitemaps helpen bij ontdekking.
Canonicals geven aan welke URL de voorkeursversie is.
Redirects sturen URL’s door.
Statuscodes vertellen of een pagina bereikbaar is.
Website structuur bepaalt hoe makkelijk belangrijke pagina’s worden gevonden.
JavaScript kan invloed hebben op rendering.
Mobielvriendelijkheid raakt hoe Google de pagina verwerkt en beoordeelt.
Daarom is dit artikel het fundament van de module.
Als je deze drie begrippen begrijpt, worden de volgende onderwerpen veel logischer.
Een goede title tag helpt weinig als Google de pagina niet kan crawlen.
Sterke content helpt minder als Google die content niet kan renderen.
Structured data helpt niet als de pagina technisch niet goed verwerkt wordt.
En interne links helpen pas echt als ze crawlbaar zijn.
Technische SEO begint dus niet bij details.
Het begint bij toegang, verwerking en indexatie.
Kan Google de pagina vinden?
Kan Google de pagina ophalen?
Kan Google de pagina goed verwerken?
Kan Google de pagina indexeren?
Als het antwoord daarop ja is, heb je de technische basis gelegd.
Daarna kun je verder optimaliseren.
❓ Vragen beantwoord in dit artikel
Wat betekenen crawlen, renderen en indexeren?
Crawlen betekent dat Google een URL bezoekt en ophaalt. Renderen betekent dat Google de pagina verwerkt zoals een browser dat doet. Indexeren betekent dat Google de pagina kan opnemen in de index. Samen vormen deze stappen de technische route voordat een pagina kan ranken.
Waarom zijn crawlen, renderen en indexeren belangrijk voor SEO?
Crawlen, renderen en indexeren zijn belangrijk omdat een pagina pas SEO-resultaat kan opleveren als Google hem goed kan verwerken. Een sterke pagina helpt weinig wanneer Google de URL niet kan vinden, de content niet kan zien of de pagina niet in de index opneemt.
Wat is crawlen?
Crawlen is het ophalen van een URL door een zoekmachine. Googlebot bezoekt pagina’s, volgt links en ontdekt nieuwe of gewijzigde URL’s. Crawlen betekent alleen dat Google de pagina heeft opgehaald. Het betekent nog niet dat de pagina ook wordt geïndexeerd of gaat ranken.
Hoe ontdekt Google nieuwe pagina’s?
Google ontdekt nieuwe pagina’s vooral via links. Interne links, externe links, XML-sitemaps, redirects en eerder bekende URL’s kunnen helpen om pagina’s vindbaar te maken. Een pagina zonder interne links hangt sneller los binnen je website en krijgt minder duidelijke context voor zoekmachines.
Wat is renderen?
Renderen betekent dat Google een pagina verwerkt zoals een browser dat doet. Dit is vooral belangrijk wanneer content, links of elementen via JavaScript worden ingeladen. Als Google een pagina niet goed kan renderen, kan belangrijke content ontbreken in wat Google uiteindelijk ziet en verwerkt.
Waarom is JavaScript belangrijk bij renderen?
JavaScript is belangrijk omdat sommige websites content pas tonen nadat scripts zijn geladen. Voor gebruikers kan dat goed werken, maar Google moet die content ook kunnen verwerken. Als belangrijke tekst, links of producten pas via JavaScript verschijnen, moet je controleren of Google ze goed kan zien.
Wat is indexeren?
Indexeren betekent dat Google informatie van een pagina verwerkt en kan opnemen in de index. Een geïndexeerde pagina kan in aanmerking komen om getoond te worden in de zoekresultaten. Indexatie betekent niet automatisch dat de pagina hoog rankt of veel organisch verkeer krijgt.
Waarom wordt een gecrawlde pagina niet altijd geïndexeerd?
Een gecrawlde pagina wordt niet altijd geïndexeerd omdat Google na het crawlen nog een selectie maakt. De pagina kan bijvoorbeeld een noindex-tag hebben, een canonical naar een andere URL bevatten, te weinig unieke waarde hebben, sterk lijken op andere pagina’s of technische fouten bevatten.
Hoe controleer je of Google een pagina kan crawlen en indexeren?
Je controleert dit vooral met Google Search Console. Gebruik URL-inspectie, test de live URL en bekijk het indexeringsrapport. Daarnaast kun je een crawltool zoals Screaming Frog gebruiken om statuscodes, interne links, noindex-tags, canonicals, redirects en andere technische patronen op schaal te controleren.
Wat is het verschil tussen gevonden, gecrawld en geïndexeerd?
Gevonden betekent dat Google de URL kent. Gecrawld betekent dat Google de URL heeft opgehaald. Geïndexeerd betekent dat de pagina kan worden opgenomen in Google’s index. Een pagina kan dus wel gevonden of gecrawld zijn, maar toch niet geïndexeerd worden of ranken.
👉 Volgende stap
Nu je weet hoe crawlen, renderen en indexeren werken, kun je beter begrijpen hoe je crawling bewust stuurt.
Daar gaat het volgende artikel over:
Robots.txt begrijpen.


